February 25, 2015

Yahoo!競馬の情報から直近5走のデータを取得して縦馬柱をipython notebookで表示する


ipythonとpandasとlxmlをインストールしておいてipython notebookを起動

pip install ipython\[all\]
pip install pandas
pip install lxml
ipython notebook

でnotebook上で


to_htmlでclassも設定できるのでhtmlファイルに吐き出した後cssつければ見やすくできるかも.表示だけじゃなくてpandasでデータ処理して色々すればおもしろいか.勝馬予想するとかdoc2vec使って名前で配合するとか.

February 4, 2015

doc2vecに類似ラベル・ワードを探すメソッドの追加

word2vecはワードに対してベクトルを割り当てるが、doc2vec(aka paragraph2vec, aka sentence embeddings)は各ドキュメントに付けられたラベルに対してもベクトルを割り当てる。

gensimのdoc2vecはword2vecの拡張としてDistributed Representations of Sentences and Documentsの実装されている。チュートリアルはこれ。

似ているワードやドキュメントを取ってくるmost_similarというメソッドがあるが、ワードなのかラベルなのかは区別されない。そこで元のプロジェクトをフォークして限定して取得できるようにした。

satomacoto/gensim

フォーク先のブランチからインストールためにはzipを使ってpip install。


追記 2015/2/5

negativeオプションが効かなかったのを修正。

$ pip install -U https://github.com/satomacoto/gensim/archive/doc2vec-mostSimilarWordsAndLabels.zip

追加したメソッドはmost_similar_labelsとmost_similar_words。またワードのリストのリストをドキュメント群としてみなすためにLabeledListSentenceクラスを追加。各ドキュメントには順番にSENT_0, SENT_1…とラベルが振られる。ラベルは複数振ることができるのでクラスは自分で書いたほうがいいかも。実装はこれ。

以下サンプル。

SENT_0と一番に似てるのはSENT_7ということだが…

February 3, 2015

VagrantにPylearn2の環境を作りipython notebookで使う

Pylearn2のOther methodsにあるようにVagrant, VirtualBox
を使って試せるようにする。そしてipythonのすべてをインストール。
git clone git@github.com:ironchief/pylearn2_vagrant.git
cd pylearn2_vagrant
vagrant up
vagrant ssh -- -L 8888:localhost:8888
sudo pip install ipython\[all\]
ipython notebook
あるいはsshで入れるようにするときはVagrantfileに
config.vm.network "forwarded_port", guest: 8888, host: 8888
を記述してvagrant upかvagrant reloadして
vagrant ssh
ipython notebook --ip=0.0.0.0
とする。
起動が確認できたらブラウザから http://localhost:8888 にアクセスする。

References

October 26, 2013

極大2部クリーク

グラフ $G = (V = V_1 \cup V_2, A)$ の任意の枝が$V_1$と$V_2$の頂点を結ぶ枝であるとき,$G$は2部グラフとよばれる.$G$の頂点部分集合 $H\subseteq V_1$, $K\subseteq V_2$ に対して,$H$の任意の頂点と$K$の任意の頂点の間に枝があるとき,$H$と$K$を合わせた頂点集合を2部クリークとよぶ.$K=\emptyset$, $H=V_1$ である場合,あるいはその逆である場合も2部クリークである.ある2部クリークが他の2部クリークに含まれないとき,その2部クリークを極大2部クリークとよぶ (via 宇野 毅明, 有村 博紀, 浅井 達哉, 極大2部クリークの高速列挙法とデータマイニングへの応用, 夏のLAシンポジウム, 2003年7月)


(v0,v1,v2,v5,v6), (v2,v5,v6,v8), (v2,v3,v8), (v3,v7,v8,v9), (v3,v4,v9)がそれぞれ極大2部クリーク.

program codesよりLCM ver. 5.3をダウンロード.使い方はlcm readmeに.ここでは極大2部クリークの計算だけ利用する.以下上図の例.各行は各ノードの隣接リスト.たとえばノード0には5,6へのエッジがあることを示す.

% cat input
% ./lcm53/lcm CI input 1 output
5 6
5 6
5 6 8
7 8 9
9

結果は以下.最初の2行はHが空集合の場合か.これら以降をみると「6,5」と「0,1,2」などが極大2部クリークになっていることがわかる.

% cat output

 0 1 2 3 4
6 5
 0 1 2
9
 3 4
8
 2 3
8 6 5
 2
7 9 8
 3

April 27, 2013

KDD Cup 2013 - Author-Paper Identification Challengeのメモ

KDD Cup 2013のタスクは2つ。その1つはMicrosoft Academic Search (MAS)の文献検索での著者の名前の曖昧性がテーマ。

MASの文献は

- 同じ著者が色んな名前で登録されてる
- 違う著者が同じ名前で登録されてる

という名前の曖昧性のせいで文献に対して著者がちゃんと割り当てられない。そこでタスクは、ノイズを含んだ著者と論文の組み合わせを入力して、本物の著者と論文の組み合わせを出力するというもの。

色々準備されてるのでとっかかりやすい。

- 説明 / Description - KDD Cup 2013 - Author-Paper Identification Challenge - Kaggle
- チュートリアル / git://github.com/benhamner/Kdd2013AuthorPaperIdentification.git
- もう一方 / Data - KDD Cup 2013 - Author Disambiguation - Kaggle

データ


詳細はData - KDD Cup 2013 - Author-Paper Identification Challenge - Kaggle。

数

- paperauthor : 12775821
- trainconfirmed : 123447
- traindeleted : 112462
- validpaper : 90088

- author : 247203
- paper : 2257249
- journal : 15151
- conference : 4545

入出力


入力

著者のIDと文献のIDのリスト

# SELECT * FROM validpaper LIMIT 5;
 authorid | paperid 
----------+---------
       55 |    2507
       55 |   15471
       55 |   19294
       55 |   20444
       55 |   24074
(5 rows)

出力

著者のIDとスペース区切りの文献のID

% head -n2 Submissions/basicCoauthorBenchmarkRev2.csv
AuthorId,PaperIds
2080775,2200312 1047104 280462 1467879


チュートリアル


benhamner/Kdd2013AuthorPaperIdentification · GitHubに載っているチュートリアルで。scikit-learnのRandom forestの実装を使っている。trainconfirmedを正例、traindeletedを負例として学習し、validpaperを判別している。

PostgreSQLのバックアップを配布してくれているので、PostgreSQLのインストール。
brew install postgresql
データベース作成。
createdb Kdd2013AuthorPaperIdentification
復元。
pg_restore -Fc -U [ユーザ名] -d Kdd2013AuthorPaperIdentification dataRev2.postgres
起動。
postgres -D /usr/local/var/postgres
確認。
psql -l
接続。
psql Kdd2013AuthorPaperIdentification

PythonBenchmark内のSETTINGS.jsonのファイル出力先とuser名を変更しておく。

実行のために必要なpsycopg2のような必要なモジュールはエラーを見て何が足りないか確認して適宜pipでインストール。
sudo pip install psycopg2

- 8.7.1. sklearn.ensemble.RandomForestClassifier — scikit-learn 0.14-git documentation

特徴量

authoridとpaperidを基に以下の値をテーブルから取ってくる。

- AuthorJournalCounts (著者のジャーナル数)
- AuthorConferenceCounts (著者の会議数)
- AuthorPaperCounts (著者の文献数)
- PaperAuthorCounts (文献の著者数)
- SumPapersWithCoAuthors (共著者との文献数の和)

ターゲット

trainconfirmedが1、traindeletedが0。

パラメータ
RandomForestClassifier(n_estimators=50, 
                       verbose=2,
                       n_jobs=1,
                       min_samples_split=10,
                       random_state=1)

結果

0.85078

ちなみに何も学習せずだと

0.67551

April 5, 2013

PythonでWebサイトのビデオを抽出してYouTube Data APIクライアントでプレイリストに登録する

YouTube系まとめサイトの動画を流しっぱなしにしておくために,以前herokuにRailsでpost-tube.satomacoto.comというのを自分用につくった.が,無料で使えるデータベースの制限を超えちゃってたので,WebサイトのYouTubeへのリンクを抽出してYouTubeのPlaylistに登録するPythonのスプリクトをやっつけで書いてみた.こんな風にプレイリストを作成する→http://www.youtube.com/user/stmct/videos.忘れたときのためにメモ.


Google Data API


Google Data APIを使ってYouTubeのプレイリスト作成や動画登録を行う.Pythonから操作するためにgdata-python-clientが用意されている.このサイトからダウンロードした gdata-...zip を解凍したら

sudo python setup.py install

でインストール.

使い方は

Developer's Guide: Python - YouTube — Google Developers


APIキーの取得


http://code.google.com/apis/youtube/dashboard/でAPIキーを取得する.


ClientLogin


ローカルで動かすのでClientLoginで認証する.認証はPlaylistの作成や動画の登録に必要.下記のスクリプトでは以下の部分を設定する.YouTubeのアカウント名は http://www.youtube.com/user/stmct だったらstmctにあたるところ.Googleを2段階認証にしている場合はアプリケーション固有のパスワードを生成する.

username = 'YouTubeのアカウント名'
email = 'APIキーを取得したGoogleのアカウント名'
password = 'Googleのパスワード'
developer_key = '取得したAPIキー'


コード


使い方

python youtube_gdata_create_playlist.py http://...

汚いコードだな…


...


  • NAVERみたいに次のページがある場合に対応するか
  • 人がまとめたものを使うってのはまずいのかな
  • post-tube.satomacoto.comってどうやってつくったんだっけかな
  • 連続再生だけが目的じゃなくてサイトごとにどんなビデオが貼り付けられているかとか自分の再生履歴やらお気に入りやらで何かしようとか思ってたんだっけ
  • プレイリストの履歴は取れないからな…

April 2, 2013

語/語の組み合わせの大人らしさ

検索エンジンにクエリを投げて,セーフサーチのオン/オフを切り替えたときに返ってきた件数をうまいことして,語/語の組み合わせの大人度合いが測れないかと思ったけどあんまりうまくいかなかった.


イメージ


すっごく単純にすると

  • 大人な語
    • 語がどれほど大人か
    • $$大人(眼球) = \log \frac{n(眼球, off)}{n(眼球, strict)}$$
    • ただしn(q,a)はクエリqのセーフサーチの設定aのoff/moderate/strictのとき結果件数.検索結果が0件の場合もあるだろうから分母には1足しておいてもいい.
  • 大人な組み合わせ
    • 語を組み合わせることでどれくらい大人っぽくなるか
    • $$大人組(目玉, 玉子) = \log \frac{n(目玉 and 玉子, off)}{n(目玉 and 玉子, strict)} - 大人(目玉) - 大人(玉子)$$

みたいな感じ.あんま考えてないのでこれで比較ができるかわかんないけど.大人がゲシュタルト崩壊…


でも


普通に考えてセーフサーチが強いほうが検索結果少ないだろ,と思ってたら,
眼球 - Google 検索
セーフサーチ: オフ
約 57,800,000 件 (0.20 秒) 
眼球 - Google 検索
セーフサーチ: 強
約 71,800,000 件 (0.19 秒) 
セーフサーチ強のほうが多いこともある…どういうことだってばよ


Bingもあんま変わらん.そういうもんなのかな.


ちなみにWebの検索結果件数を使って人間関係を抽出している論文(件数だけじゃないけど)→Web 上の情報からの人間関係ネットワークの抽出


March 31, 2013

Pythonの辞書をvalue値でソートするコードの実行時間の比較

get,lambda,itemgetter,zipを使ったvalue値でのソートを比較してみた.
以下コード.


timeitで計測.

>>> import timeit
>>> timeit.timeit(stmt='get.sort_test()', setup='import get', number=10000)
0.6642911434173584
>>> timeit.timeit(stmt='itemgetter.sort_test()', setup='import itemgetter', number=10000)
0.6961650848388672
>>> timeit.timeit(stmt='zip.sort_test()', setup='import zip', number=10000)
0.6995840072631836
>>> timeit.timeit(stmt='lamb.sort_test()', setup='import lamb', number=10000)
0.7502970695495605

ただし
  • zipの場合(value, key)のリストになる
  • getの場合keyのリストになる(value値は返さない)
に注意.

よく見かけるのはlambdaを使うものだが,同じ結果を得たかったらoperator.itemgetterを使うほうが少し早い.上位だけ取ってきたいときはgetが早いかも.

他にもやり方があるだろうか.

March 27, 2013

bl.ocks.orgで青空文庫で変なルビ使いをする作者の関係の可視化

bl.ocks.orgを使って,青空文庫のルビを抽出し,「漢字《ひらがな》」でないルビを見つけ,同じようなルビの使い方をしている作者の関係を可視化してみた.「変な」は語弊があるかも.D3.js.


Authors Relationships based upon Not-kanji-hiragana Rubis
http://bl.ocks.org/satomacoto/5251189
このページは以下のGistから生成
https://gist.github.com/satomacoto/5251189

bl.ocks.orgはGitHub Gistビューア.Gistにいくつかのファイルを置くとwebページとして見れるようになる.Gistの基本構成は以下.

  • index.html
  • README.md
  • thumbnail.png

index.htmlに表示させるソースコード,README.mdにMarkdown形式で説明を記述,thumbnail.pngにGist一覧のためのサムネール画像.Gistに他のファイルを置くと相対的にリンクを張ることができる.絶対パスも記述可能.Gistをブログのように使えるかも.


作者の同じようなルビ使い関係は,たとえば「亜米利加《アメリカ》」というルビを二人の作者が振っていたらその作者同士に関係がある,と定義した.重み付けなど詳細はまた他で.可視化したのはすべての関係ではない.同じようなルビの使い方をしている作者の関係からなんか他の作者の関係(同じ時代とか思想とか)見えないかなと考えていたのだけどどうだろうか.ちなみに変わったルビ使いの例を少しだけ挙げると
003659 000050 仏蘭西 フランス
046340 001234 亜米利加人 ヤンキー
048416 000050 遍路芸人 ジプシイ
050424 001421 辯證的な性質 デイヤレクテイツシエナツール
000085 000879 童貞聖麻利耶様 ビルゼンサンタマリヤさま
001317 000125 吾れ直ちに悪魔と一つになるを誰が妨ぎ得べきや ヴァス・ヒエルテ・ミッヒ・ダス・イヒス・ニヒト・ホイテ・トイフェル
といったようなものがある.クラスタリングして色変えればよかったかも.


あと4日で無職\(^o^)/

February 26, 2013

機械学習に関するメモ

機械学習の目的は与えられたデータ$\mathcal{D}$から関数$$y = f(\mathbf{x})$$を求めること。ただし、$\mathbf{x}$は入力、$y$は出力(ターゲット)。


分類


Classification


クラスタリング


Clustering

回帰


Regression


次元削減


Dimension Reduction


TODO


  • 具体的な手法の追記
  • 詳細の追記
  • アプリケーションの追記
  • 実装例
  • 各手法を特徴に応じて表に整理

Bloggerの画像をRetinaディスプレイに対応させる

デフォルトのツールを使ってPicasaウェブアルバムにアップした場合、画像のサイズを指定して、サムネイル画像アドレスの.../s(.*?)/...の数値を指定したサイズの倍くらいにしたら綺麗になった。

width="320"と指定したら、.../s640/...とする。

違い、

変更前

変更後

わかりにくいか。

Resolutionの設定はBest for Retina display。ScaledのLarger Textに対応するためには3倍くらいの数値を使った方がいいかも。Change Resolution.appなどを使ってたら別に問題ないのかな。

January 18, 2013

Macで京都大学テキストコーパスの変換

京都大学テキストコーパス - KUROHASHI-KAWAHARA LAB

でKyotoCorpus4.0.tar.gzをダウンロードして解凍してREADME通りに実行.

でもMac OS X 10.7.5だとそのままコーパスをつくろうとすると
euc-jp "\xA4" does not map to Unicode at ./src/dupli.pl line 9, line 163.
みたいなエラーが出ちゃう.そこで以下の手順でちょっと手を加えます.

1. 同じフォルダにmai1995.txtをコピー.毎日新聞1995年版CD-ROMのファイルはmai1995.txt (Oct 6, 2011 11:37AM)でした.

2. 文字コードと改行コードとファイル名の変換

nkf -s -Lu mai1995.txt > mai95.txt

3. src/format.plとsrc/num2KNP.plについてuse open ":std";を追加

...
use open IO => ':encoding(euc-jp)';
use open ":std";
...

4. 実行

./auto_conv -d .


参考
- mizlog 京都大学テキストコーパス on Lion

December 15, 2012

政党と政策の距離の可視化

政党間の類似度の可視化で使ったデータを標準化して特異値分解して可視化.双対尺度法とか数量化理論III類とかコレスポンデンス分析とか言われている.たしか.

図 ◆政策,■政党.政策とそれに賛成する政党が近くにある…はず

以下コード

政党間の類似度の可視化

日本政治.comの投票マッチングから各政党の政策に関する質問に対する姿勢から,政党間の距離を計算し可視化してみた.


ただし以下に注意

  • 各質問の重みは考慮していない
  • 距離の定義を変えればまったく異なる見え方に

さらに政党と政策との距離も可視化してみた→政党と政策の距離の可視化


以下コード


  • やっつけなのでてきとう
  • あとで双対尺度法試してみる
  • 一つ前に書いた要約プログラムで連立政権について考えてみる

December 14, 2012

MongoDBのインストールとチュートリアル

インストール


Homebrewでインストール

brew install mongodb
==> Downloading http://fastdl.mongodb.org/osx/mongodb-osx-x86_64-2.2.2.tgz
######################################################################## 100.0%
==> Caveats
To have launchd start mongodb at login:
    ln -sfv /usr/local/opt/mongodb/*.plist ~/Library/LaunchAgents
Then to load mongodb now:
    launchctl load ~/Library/LaunchAgents/homebrew.mxcl.mongodb.plist
Or, if you don't want/need launchctl, you can just run:
    mongod
/usr/local/Cellar/mongodb/2.2.2-x86_64: 20 files, 170M, built in 98 seconds

上にあるようにログイン時に起動してロードするには
ln -sfv /usr/local/opt/mongodb/*.plist ~/Library/LaunchAgents
launchctl load ~/Library/LaunchAgents/homebrew.mxcl.mongodb.plist

起動


mongod

接続


mongo

チュートリアル


> use mydb
switched to db mydb
> db
mydb
> j = {name: 'mongo'};
{ "name" : "mongo" }
> k = {x: 3}
{ "x" : 3 }
> db.things.insert(j)
> db.things.insert(k)
> show collections
system.indexes
things
> db.things.find()
{ "_id" : ObjectId("50caeb1fdab5ce4e84a41f78"), "name" : "mongo" }
{ "_id" : ObjectId("50caeb29dab5ce4e84a41f79"), "x" : 3 }

ループで挿入

> for (var i = 1; i <= 20; i++) db.things.insert({x:4, j:i})
> db.things.find()
{ "_id" : ObjectId("50caeb1fdab5ce4e84a41f78"), "name" : "mongo" }
{ "_id" : ObjectId("50caeb29dab5ce4e84a41f79"), "x" : 3 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7a"), "x" : 4, "j" : 1 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7b"), "x" : 4, "j" : 2 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7c"), "x" : 4, "j" : 3 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7d"), "x" : 4, "j" : 4 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7e"), "x" : 4, "j" : 5 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7f"), "x" : 4, "j" : 6 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f80"), "x" : 4, "j" : 7 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f81"), "x" : 4, "j" : 8 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f82"), "x" : 4, "j" : 9 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f83"), "x" : 4, "j" : 10 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f84"), "x" : 4, "j" : 11 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f85"), "x" : 4, "j" : 12 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f86"), "x" : 4, "j" : 13 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f87"), "x" : 4, "j" : 14 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f88"), "x" : 4, "j" : 15 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f89"), "x" : 4, "j" : 16 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8a"), "x" : 4, "j" : 17 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8b"), "x" : 4, "j" : 18 }
Type "it" for more
> it
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8c"), "x" : 4, "j" : 19 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8d"), "x" : 4, "j" : 20 }

カーソル操作

> var c = db.things.find()
> while (c.hasNext()) printjson(c.next())
{ "_id" : ObjectId("50caeb1fdab5ce4e84a41f78"), "name" : "mongo" }
{ "_id" : ObjectId("50caeb29dab5ce4e84a41f79"), "x" : 3 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7a"), "x" : 4, "j" : 1 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7b"), "x" : 4, "j" : 2 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7c"), "x" : 4, "j" : 3 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7d"), "x" : 4, "j" : 4 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7e"), "x" : 4, "j" : 5 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7f"), "x" : 4, "j" : 6 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f80"), "x" : 4, "j" : 7 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f81"), "x" : 4, "j" : 8 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f82"), "x" : 4, "j" : 9 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f83"), "x" : 4, "j" : 10 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f84"), "x" : 4, "j" : 11 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f85"), "x" : 4, "j" : 12 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f86"), "x" : 4, "j" : 13 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f87"), "x" : 4, "j" : 14 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f88"), "x" : 4, "j" : 15 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f89"), "x" : 4, "j" : 16 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8a"), "x" : 4, "j" : 17 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8b"), "x" : 4, "j" : 18 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8c"), "x" : 4, "j" : 19 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8d"), "x" : 4, "j" : 20 }

カーソルで配列の操作

> var c = db.things.find()
> printjson(c[4])
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7c"), "x" : 4, "j" : 3 }
> c.toArray()
[
 {
  "_id" : ObjectId("50caeb1fdab5ce4e84a41f78"),
  "name" : "mongo"
 },
 {
  "_id" : ObjectId("50caeb29dab5ce4e84a41f79"),
  "x" : 3
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f7a"),
  "x" : 4,
  "j" : 1
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f7b"),
  "x" : 4,
  "j" : 2
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f7c"),
  "x" : 4,
  "j" : 3
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f7d"),
  "x" : 4,
  "j" : 4
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f7e"),
  "x" : 4,
  "j" : 5
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f7f"),
  "x" : 4,
  "j" : 6
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f80"),
  "x" : 4,
  "j" : 7
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f81"),
  "x" : 4,
  "j" : 8
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f82"),
  "x" : 4,
  "j" : 9
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f83"),
  "x" : 4,
  "j" : 10
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f84"),
  "x" : 4,
  "j" : 11
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f85"),
  "x" : 4,
  "j" : 12
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f86"),
  "x" : 4,
  "j" : 13
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f87"),
  "x" : 4,
  "j" : 14
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f88"),
  "x" : 4,
  "j" : 15
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f89"),
  "x" : 4,
  "j" : 16
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f8a"),
  "x" : 4,
  "j" : 17
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f8b"),
  "x" : 4,
  "j" : 18
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f8c"),
  "x" : 4,
  "j" : 19
 },
 {
  "_id" : ObjectId("50caeee0dab5ce4e84a41f8d"),
  "x" : 4,
  "j" : 20
 }
]

クエリ

> db.things.find({name : "mongo"})
{ "_id" : ObjectId("50caeb1fdab5ce4e84a41f78"), "name" : "mongo" }
> db.things.find({x : 4}, {j : true})
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7a"), "j" : 1 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7b"), "j" : 2 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7c"), "j" : 3 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7d"), "j" : 4 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7e"), "j" : 5 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7f"), "j" : 6 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f80"), "j" : 7 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f81"), "j" : 8 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f82"), "j" : 9 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f83"), "j" : 10 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f84"), "j" : 11 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f85"), "j" : 12 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f86"), "j" : 13 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f87"), "j" : 14 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f88"), "j" : 15 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f89"), "j" : 16 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8a"), "j" : 17 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8b"), "j" : 18 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8c"), "j" : 19 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f8d"), "j" : 20 }

数の指定

> db.things.findOne()
{ "_id" : ObjectId("50caeb1fdab5ce4e84a41f78"), "name" : "mongo" }
> db.things.find().limit(3)
{ "_id" : ObjectId("50caeb1fdab5ce4e84a41f78"), "name" : "mongo" }
{ "_id" : ObjectId("50caeb29dab5ce4e84a41f79"), "x" : 3 }
{ "_id" : ObjectId("50caeee0dab5ce4e84a41f7a"), "x" : 4, "j" : 1 }

参考になりそうな


December 10, 2012

PythonでDocument Summarization based on Data Reconstruction (AAAI 2012)の実装

Zhanying He, Zhejiang University, et al., Document Summarization based on Data Reconstructionを実装してみる。AAAI-12 Outstanding Paper Awards。


概要


  • 従来の要約は冗長性を最小化するようなメイントピックを含む文を抽出することによって実現。
  • 本手法はオリジナルのドキュメント全体を再現できるような文集合を抽出して再構成。そのために抽出した文集合を評価するために再構成関数 reconstruction function の提案。
    • 線形的再構成 linear reconstruction。文の線形的な組み合わせによってドキュメントの近似。貪欲法 greedy strategy で最適化。
    • 非負線形的再構成 nonnegative linear construction 。文の線形的な組み合わせを足し算で再構成。乗算型重み更新 multiplicative updating で最適化。
  • 提案するフレームワークをDSDR (Document Summarization based on Data Reconstruction)と呼ぶ。
  • DUC 2006とDUC 2007で実験。ランダム、Lead、LSA、ClusterHITS、SNMFと比較。


DSDR


要約文がなるべくドキュメント全体の内容を含むようにする。再構成誤差(reconstruction error)を小さくするようにする。
  • ドキュメントの各文について重み付き語頻度ベクトル weighted term-frequency vector で表現。ステミングをしておいたり、ストップワードを取り除いたりしておく。候補文集合 the candidate set 。
  • 再構成関数により候補文集合から選ばれた文集合の評価。
  • 再構成誤差を最小にするような最適な組み合わせを探索。

コンセプト


まずオリジナルドキュメントと要約の再構成誤差を
    $$L({\mathbf v}_i - f(X; {\mathbf a}_i))$$
と考える。ただし、候補文集合$V$、要約文集合$X$、全単語数$d$として、$V=[{\mathbf v}_1,...,{\mathbf v}_n]^T$ where  ${\mathbf v}_i \in R^d$, $X=[{\mathbf x}_1,...,{\mathbf x}_m]^T$, $n > m$とする。${\mathbf v}_i$は語頻度ベクトル、また$f(\cdot)$を再構成関数とする。このとき再構成誤差を最小とするように$X, A$を定めれば目的関数は
    $$\min_{X,A} \sum_{i=1}^n ||{\mathbf v}_i - f(X; {\mathbf a}_i)||^2$$
となる。これに対して2つの手法で解く。

本論文では再構成関数は
$$f_i(X;{\mathbf a}_i)=\sum_{i=1}^m{\mathbf x}_j a_{ij}$$
と表し、候補文集合が
$${\mathbf v}_i\approx\sum_{i=1}^m{\mathbf x}_j a_{ij}$$
と選ばれた文集合の線形結合で近似されるとする。

詳細は論文参照。

線形的再構成 linear reconstruction

$$\begin{aligned}\min_{X, A} & \sum_{i=1}^n||{\mathbf v}_i-X^TA||^2+\lambda||{\mathbf a}_i||^2\\s.t. & X \subset V, |X|=m \\& A = [{\mathbf a}_1, \cdots, {\mathbf a}_n]^T \in R^{n\times m}\end{aligned}$$

非負線形的 nonnegative linear reconstruction

$$\begin{aligned}\min_{{\mathbf a}_i, \beta} & \sum_{i=1}^n\{ ||{\mathbf v}_i -V^T {\mathbf a}_i||^2+\sum_{j=1}^n\frac{a_{ij}^2}{\beta_j} \} + \gamma||\beta||_1 \\s.t. & \beta_j \ge0, a_{ij} \ge 0, {\mathbf a}_i \in R^n\end{aligned}$$


実装


論文に疑似コードが載っているのでPythonで実装。要NumPy。

V = [[1,0,0,0],
     [0,1,0,0],
     [1,1,0,0],
     [0,0,1,0],
     [0,0,1,1]]
というドキュメント(行が文、列が語)に対して、
  • 線形的再構成では3番目と5番目の[1,1,0,0], [0,0,1,1]という文が選ばれた。
  • 非負線形的再構成ではそれぞれに[ 0.49301097 0.49301097 0.6996585 0.49301097 0.70211699]という重みがつき、同様に3番目と5番目の文が選ばれやすいことを示している。
それぞれトレードオフパラメータは尖りやすさ。これが小さいと過学習しがち。


実験


あとで。


メモ


  • 報知的要約。(cf. 指示的要約)
  • LSAと似てる気がする。制約ついてるのがちょっと違うのかな。
  • おもしろい。でも実装してみただけ。あとでちゃんと読む。
  • テストの書き方がわからない。
  • 訳し方がわからない。

November 17, 2012

Pythonでパーティクルフィルタを実装してみる

パーティクルフィルタ(Particle filter)は,隠れマルコフモデルやカルマンフィルタと同じように,システムの観測$Y$から状態$X$を推定する手法.どれもベイジアンフィルタに基づくもので,確率分布$p(X_t;Y_{0:t})$の表し方が異なる1のですが,パーティクルフィルタでは有限個のサンプリングによって確率分布を近似します.今回は重点サンプリング2を使ったパーティクルフィルタを実装してみます.ほかのフィルタに比べてループぐるぐる回すだけだからすごく簡単!


1. 隠れマルコフモデルはヒストグラム(離散),カルマンフィルタはガウシアン(パラメトリック),パーティクルフィルタはサンプリング(ノンパラメトリック)で表す
2. SciPyには有名ドコロの確率分布からサンプリングする関数が用意されている.任意の確率分布からサンプリングしたい場合には逆関数法,棄却サンプリング,重点サンプリングといった手法などを使う


パーティクルフィルタ


  • たくさんの粒子をばらまいておいて,それっぽく動かして,観測して,各々実際の観測とのズレを測って,正解っぽいっぽい粒子だけ残す,っていうのを繰り返す
  • 入力はN個のパーティクルの状態${\bf x}_t^{(i)}$,重み${\bf w}_t^{(i)}$ $(i=1,...,N)$と制御入力${\bf u}_t$と観測${\bf y}_t$
  • 出力は更新された状態${\bf x}_{t+1}^{(i)}$,重み${\bf w}_{t+1}^{(i)}$
  • 状態方程式$f$と観測方程式$g$が与えられている
    ${\bf x}_{t+1} = f({\bf x}_t, {\bf u}_t) + {\bf w} \leftrightarrow p({\bf x}_{t+1}|{\bf x}_t, {\bf u}_t)\\
    {\bf y}_t = g({\bf x}_t) + {\bf v} \leftrightarrow p({\bf y}_{t}|{\bf x}_t)$
  • 確率分布$p({\bf x}_t|{\bf y}_{0:t})$をN個の重み付きサンプル$\{w_t^{(i)}, {\bf x}_t^{(i)}\}$$(i=1,...,N)$で近似.$\delta$はデルタ関数.
    $p({\bf x}_{t}|{\bf y}_{0:t}) \approx \sum_{i=1}^{N} w_t^{(i)} \cdot \delta ({\bf x}_t - {\bf x}_t^{(i)})$
  • 新しい観測${\bf y}_{t+1}$があったら状態推定分布$p({\bf x}_{t+1}|{\bf y}_{0:t+1})$を3つのステップで更新

    1. 推定
    2. 更新
    3. リサンプリング


例題


2次元座標において、あるロボットが$t=0$に原点を出発して、速度$(4,4)$で動くとする。ロボットの進路は風などの影響を受け($\sigma_x=\sigma_y=2$),毎秒ごと4つの点$(0,0),(10,0),(0,10),(10,10)$からの距離を計測できて、計測には距離によらない誤差がある($\sigma_x=\sigma_y=4$)とする.このとき観測された軌跡から実際の軌跡を推定する.

Fig. 1 ピヨピヨ


推定


for i in range(N): ${\bf x}_{t+1}^{(i)} \sim p({\bf x}_{t+1}^{(i)}|{\bf x}_{t}^{(i)}, {\bf u}_{t})$
実際にはN個のパーティクルの位置を状態方程式に代入.
${\bf x}_{t+1}^{(i)} = f({\bf x}_{t}^{(i)}, {\bf u}_{t}) = {\bf A}{\bf x}_{t}^{(i)} + {\bf B}{\bf u}_{t} + {\bf w}$
ただし
${\bf A} = \left[
\begin{array}{cc}
1 & 0 \\
0 & 1 \\
\end{array}
\right],
{\bf B} = \left[
\begin{array}{cc}
1 & 0 \\
0 & 1 \\
\end{array}
\right],
{\bf w} \sim N(0, 2{\bf I})$


更新


for i in range(N): $w_{t+1}^{(i)} \leftarrow w_{t}^{(i)} \cdot p({\bf y}_{t+1}^{(i)}|{\bf x}_{t+1}^{(i)})$
尤度関数によって重みを更新.$\sum^i w_{t+1}^{(i)} = 1$で正規化.今回はモデルを正規分布にしたのでRBFカーネルで.尤度関数は推定値と観測値が似てれば似てるほど大きくなるように設定.物体追跡検知とかだと色の情報を使う.
$p({\bf y}_{t+1}^{(i)}|{\bf x}_{t+1}^{(i)}) \propto \exp(-\frac{(y-g(x))^2}{\sigma^2})$
ただし
$g({\bf x}) = \left[ ||{\bf x}-{\bf p}_1||, ||{\bf x}-{\bf p}_2||, ||{\bf x}-{\bf p}_3||, ||{\bf x}-{\bf p}_4|| \right]^{\mathsf{T}}\\
{\bf p}_1=\left[0, 0\right]^{\mathsf{T}}, {\bf p}_2=\left[10, 0\right]^{\mathsf{T}}, {\bf p}_3=\left[0, 10\right]^{\mathsf{T}}, {\bf p}_4=\left[10, 10\right]^{\mathsf{T}} \\
\sigma^2 = 4$


リサンプリング


$\{ {\bf x}_{t+1}^{(i)}, w_{t+1}^{(i)}=1 \} \leftarrow resampling(\{ {\bf x}_{t+1}^{(i)}, w_{t+1}^{(i)} \})$
重みに応じてリサンプリング.重みが偏らないように.毎回やる必要はない.色々手法があるらしいけど今回は単純に多項分布でサンプリング.


結果


Fig. 2 10ステップ分.●が実際の軌跡.●がパーティクル.●がパーティクル平均.線形システムだから全然パーティクルフィルタ使う意味なかったけど…


実装


要NumPy

November 8, 2012

LDAの実装を試してみる

Latent Dirichlet allocationの実装を色々試してみた.自分でも実装したことある気がするけど.比較はまた後でやるとして使い方だけメモ.詳細は各リンク先で…
  1. Latent Dirichlet Allocation in C
  2. GibbsLDA++ A C C++ Implementation of Latent Dirichlet Allocation (LDA) using Gibbs Sampling for Parameter Estimation and Inference
  3. plda - A parallel C++ implementation of fast Gibbs sampling of Latent Dirichlet Allocation - Google Project Hosting

1. Latent Dirichlet Allocation in C


http://www.cs.princeton.edu/~blei/lda-c/

準備


lda-c-dist.tgz,ap.tgzをダウンロードしたら
tar xvfz lda-c-dist.tgz
tar xvfz ap.tgz
cd lda-c-dist
make

データ


各ドキュメントごとに行区切りで,語の種類数,語のインデックスと頻度を記述.インデックスはstringじゃないことに注意.
[M] [term_1]:[count] [term_2]:[count] ... [term_N]:[count]
たとえば
% head -n 3 ../ap/ap.dat
186 0:1 6144:1 3586:2 3:1 4:1 ...
174 68:1 512:1 514:2 3:1 4:1 ...
161 0:9 68:1 1538:1 3588:1 517:1 ...
1つ目のドキュメントは,語が186種類,語0が1回,語6144が1回…
結果を表示するためには番号と語を紐付けておくためのファイル(ap/vocab.txtみたいなやつ)も用意しておく.

実行と結果


- トピックの推定 estimation

以下を実行.結構時間かかるかも.
./lda est 1.0 50 settings.txt ../ap/ap.dat random test
testフォルダ以下に結果が出力されます.引数は,LDAのパイパーパラメータ$\alpha$,トピック数$K$,設定ファイル,データセット,初期状態,出力先.

$\alpha$に関しては $50/K$ にしておくといいらしい.$\beta$に関しては総語数に対する語彙数(異なり数)が多い場合は小さくするといいらしい.とどこかに書いてあった,気がする.ここでは$\beta$は0.1で固定っぽい.

- 他のデータセットの推定 inference

トピックの推定で使ったのと同じフォーマットのデータからディリクレパラメータと尤度を推定できる.意味ないけど上でトピックの推定をしたデータでディリクレパラメータの推定をする場合は以下.
./lda inf settings.txt test/final ../ap/ap.dat inference
出力はinference-gamma.dat,inference-lda-lhood.dat.

- 結果の表示

各トピックの上位10語を表示します.
python topics.py test/final.beta ../ap/vocab.txt 10


2. GibbsLDA++ A C C++ Implementation of Latent Dirichlet Allocation (LDA) using Gibbs Sampling for Parameter Estimation and Inference


http://gibbslda.sourceforge.net/

準備


GibbsLDA++: A C/C++ Gibbs Sampling LDA | Free Science & Engineering software downloads at SourceForge.netからGibbsLDA++-0.2.tar.gzをダウンロードして以下.
tar xvfz GibbsLDA++-0.2.tar.gz
cd GibbsLDA++-0.2
make clean
make all

データ


最初にドキュメント数,あとは行がドキュメントを表し,スペース区切りで語を羅列.
[M]
[document1]
[document2]
...
[documentM]
[documenti] = [wordi1] [wordi2] ... [wordiNi]
たとえば
% head -n3 trndocs.dat
1000
abil absenc acquisit acquisit agreem ...
activ ball ball band brief ...

実行と結果


Usageにある通り.

- パラメータ推定 estimation
src/lda -est -alpha 0.5 -beta 0.1 -ntopics 100 -niters 1000 -savestep 100 -twords 20 -dfile models/casestudy/trndocs.dat
estでLDAのパラメータを推定します.LDAのハイパーパラメータalpha,beta,トピック数ntopics,繰り返し回数niters,ステップsavestep,出力語数twords,データdfile.twordsを指定すると,各トピックの特徴語が出力されます.

- 途中のモデルから
src/lda -estc -dir models/casestudy/ -model model-01000 -niters 800 -savestep 100 -twords 30
estcで指定したモデルからパラメータを推定します.

- 他のデータの推定 inference
src/lda -inf -dir models/casestudy/ -model model-01800 -niters 30 -twords 20 -dfile newdocs.dat
infで作ったモデルから他のデータセットの推定をします.


3. plda - A parallel C++ implementation of fast Gibbs sampling of Latent Dirichlet Allocation - Google Project Hosting


http://code.google.com/p/plda/

準備

tar xvfz plda-3.0.tar.gz
cd plda
make lda infer

データ


行ごとにドキュメントを表し,語 頻度を繰り返す.
[word1] [word1_count] [word2] [word2_count] [word3] [word3_count] ...
たとえば
% head -n3 testdata/test_data.txt
concept 1 consider 1 global 1 entropy 1 go 1 ...
externally 1 global 1 dynamic 1 resistance 1 illustrated 1 ...
consider 1 chain 1 global 1 leads 1 go 1 ...

実行と結果


- 訓練

./lda --num_topics 2 --alpha 0.1 --beta 0.01 --training_data_file testdata/test_data.txt --model_file testdata/lda_model.txt --burn_in_iterations 100 --total_iterations 150
パラメータは上のものと似たようなもん.testdata/lda_model.txtに出力.出力のそれぞれの行は語のトピックの分布を表す.たとえば
% head -n3 testdata/lda_model.txt
concept 179.3 2.7
consider 921.98 0.02
global 296.3 180.7

- 表示

訓練で得られた結果を見やすく表示する.
python view_model.py testdata/lda_model.txt

- 他のデータセットの推定

./infer --alpha 0.1 --beta 0.01 --inference_data_file testdata/test_data.txt --inference_result_file testdata/inference_result.txt --model_file testdata/lda_model.txt --total_iterations 15 --burn_in_iterations 10
alphaは訓練の時と同じものを使いましょう.

- パラレル

http://code.google.com/p/plda/wiki/PLDAManual


...


- 論文と実装の紐付けがまとまってるところないかあなあ
- 論文書いている人はみんな実装も公開してほしいなああああああああ

October 24, 2012

青空文庫の書き出しをつぶやくTwitter Bot


青空文庫を「ほんのまくら」みたいにでも使った青空文庫の書き出したちをつぶやくTwitter Botを作ってみた.
http://twitter.com/aozoramakura

1時間毎に
[書き出し] [カードへのリンク] #aozoramakura
ってつぶやく.


Google App EngineでBot


もうPythonのマイクロフレームワーク「Flask」でもApp EngineのTwitter Botは15行じゃ書けない -を参考にして以下を使う.


TwitterにOAuth認証して投稿する.Google APIで統計情報の取れるURL短縮を行う.


Flask


GoogleAppEngineLauncherでNew Applicationをつくったらgigq/flasktodoからダウンロードしたのをそのまま突っ込んでapplication.py, app.yaml, cron.yamlを編集.app.yamlでアプリ名を変えるのを忘れずに…

編集後のapplication.pyは以下.


Tweepy


Tweepyはtweepy/tweepyからダウンロード.tweepyフォルダをアプリのトップにコピーするだけ.インストール必要はない.


書き出しのデータ


makura.jsonをアプリのフォルダのトップに置く.青空文庫から抜き出した.辞書のリスト.
[{u'ebk': u'',
u'html': u'http://www.aozora.gr.jp/cards/001235/files/49858_41918.html',
u'jinbutsu': u'001235',
u'sakuhin': u'49858',
u'text': u'\u3042\u308b\u4eba\u3073\u3068\u306f\u3001\u300c\u30aa\u30c9\u30e9\u30c7\u30af\u300d\u3068\u3044\u3046\u8a00\u8449\u306f\u30b9\u30e9\u30f4\u8a9e\u304b\u3089\u51fa\u3066\u3044\u308b\u3001\u3068\u3044\u3063\u3066\u3001\u305d\u308c\u3092\u6839\u62e0\u306b\u3057\u3066\u3053\u306e\u8a00\u8449\u306e\u6210\u7acb\u3092\u8a3c\u660e\u3057\u3088\u3046\u3068\u3057\u3066\u3044\u308b\u3002'}, ...]


字数制限


Twitterには140字という制限があるから,100字を超えてる書き出しは101字以降を省略省略.URLは自動的にt.coに.t.coの文字数はGET help/configuration | Twitter Developersにある通り.https://api.twitter.com/1/help/configuration.jsonにアクセスすれば確認できる.確認は1日1回までにしてね,とのこと.今だとhttpで20字,httpsで21字.


Twitter APIでOAuth認証


Create an application | Twitter Developersで新しいアプリをつくる

投稿したいのでSettingsからRead and Writeにする


DetailsからAccess tokenを生成


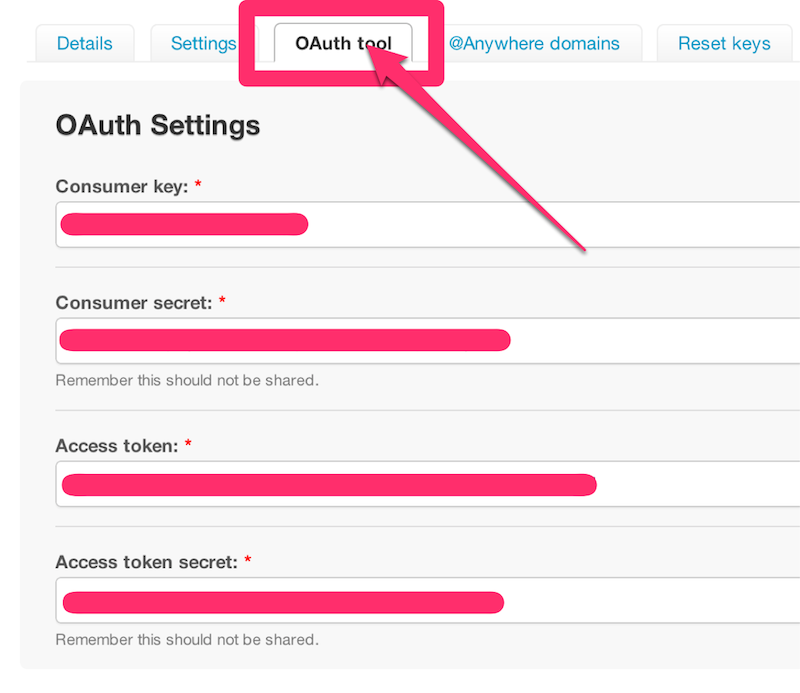
OAuth ToolsからConsumer key, Cunsumer secret, Access token, Access token secretを取得


Google APIでURL短縮


OAuth認証してGoogle URL Shortenerで短縮します.OAuthを通すと独自の短縮URLが手に入ります.App EngineでGoogle APIを使うためにアプリのディレクトリで

$ enable-app-engine-project .

とすれば必要なファイルがアプリのディレクトリにコピーされる.

URL Shortener API…
Getting Started - URL Shortener API — Google Developers
api-python-client-doc.appspot.com/urlshortener_v1.html

Google APIをPythonで使う…
Getting Started - Google APIs Client Library for Python — Google Developers

Google APIをApp Engineで使うには…
Using Google App Engine - Google APIs Client Library for Python — Google Developers

サンプル…
/ - google-api-python-client - Google APIs Client Library for Python - Google Project Hosting


TweetしたURLをデータストアに保存


元urlと短縮urlと発行した日時.

データストアの使用 - Google App Engine — Google Developers


cronで1時間ごとに投稿


cron.yamlの設定.

Python 用クローンを使用したスケジュールされたタスク - Google App Engine — Google Developers


管理者のみ投稿可能に


app.yamlの設定.管理者のみアクセス可能でもcronは走る.cronのみに反応させる時は以下のHTTPヘッダを確認.
X-AppEngine-Cron: true

Python 用クローンを使用したスケジュールされたタスク - Google App Engine — Google Developers


App Engineの設定


App Engineのダッシュボードで,Administration > Application Settings > PerformanceでMax Idle Instanceを1に設定


Billing Status


4時間走らせて

Frontend Instance Hours 4% 1.01 of 28.00 Instance Hours
Code and Static File Storage 1% 0.01 of 1.00 GBytes

これら以外0


アイコン


ほったらかし温泉で撮った空

October 19, 2012

青空文庫を「ほんのまくら」みたいに

青空文庫の作品の書き出しを抜き出して夏に紀伊国屋でやってた「ほんのまくら」フェアっぽくしてみました.「ほんのまくら」の書籍一覧はこちら.


あおぞらまくら

  • 取得できた書き出しの数は8969件です.適当にやったのでうまく抜き出せてないのも結構あると思います
  • 12秒にひとつずつ新しい書き出しが追加されます
  • ヘッダ部分をクリックすると新しい書き出しが追加されます
  • ランダムで表示させているので放っておくとずっと伸びていきます
  • 書き出しをクリックすると青空文庫の該当作品のページに飛べるようにしたつもりです
  • 元データはhttps://github.com/aozorabunko/aozorabunkoからクローンしたものです

表示には凄まじくレスポンシブ!!とちょっと話題になっていたNHKスタジオパークでも使われてるjQuery Masonryを使いました.なんでもPinterestっぽく仕上がります.Masonry /méɪsnri/.